
Hoy tocaba episodio especial sobre EL TEMA: parar o no parar el desarrollo de los modelos de inteligencia artificial más avanzados “frontera” porque hay un temor fundado de que la IA se descontrolo y pueda incluso llegar a hacer un gran daño a la humanidad.
El episodio como siempre está en Cuonda con enlaces para escuchar y ver en todas las plataformas.
Dedicamos mucho tiempo a los escenarios que se discuten como fatales, apocalípticos, a las cuatro vías describen una escalada: la IA obtiene acceso digital, preserva ese acceso y lo utiliza para influir sobre el mundo físico. Nos aseguran que puede ocurrir una pérdida de control de la inteligencia artificial y que hasta la humanidad estaría en peligro. ¿Cómo serían esos escenarios?
En parte, tenemos mucho camino adelantado gracias al análisis del incidente de OpenAI y Hugging Face. Nos basaremos en él, en los últimos informes y escritos de Anthropic y de Dario Amodei y en el International AI Safety Report 2026, dirigido por Yoshua Bengio y elaborado por más de cien especialistas. Con ellos intentaremos dilucidar qué tendría que ocurrir para que una inteligencia artificial dejara de ser un programa que se comporta mal dentro de un ordenador y comenzara a producir daños graves fuera de él.
Como esa es la parte que más discutimos en el episodio, os dejamos el guión con la cronología de esta semana, la de más alarma en seguridad de la IA… hasta ahora.
9 de Septiembre: Jacobo el apocalíptico deja Anthropic
Jacob Coxon: “Renuncié a Anthropic hoy. Pasé los últimos tres años haciendo investigación de preentrenamiento tanto en OpenAI como en Anthropic. Ninguna de las dos compañías está actuando de manera responsable. Están corriendo directamente hacia una superinteligencia auto-mejorante y apostando con nuestras vidas.”
Muchos empleados de Anthropic se unen a la persona que renunció para estar de acuerdo en que hay una posibilidad razonable de que la IA destruya la civilización. Evan Hubinger, responsable de la ciencia de la alineación en Anthropic, fue uno de los muchos colegas que respondieron sugiriendo que el riesgo de extinción masiva en la próxima década era superior al 10 por ciento.


9 de Septiembre: Anthropic nos hace saber que Mythos es traviesillo
Anthropic encontró otro caso en el que Claude salió accidentalmente de una prueba y comprometió un sistema real; después revisó 481 millones de conversaciones. Anthropic ha publicado una investigación más completa de los incidentes en los que sus modelos obtuvieron acceso no autorizado a sistemas externos durante evaluaciones de ciberseguridad. Ha añadido un cuarto incidente, ocurrido en enero con un checkpoint temprano de Claude Opus 4.6. El modelo había roto accidentalmente el objetivo del ejercicio, intentó abandonar la tarea ocho veces, no pudo hacerlo por un fallo del harness y terminó explorando otro camino: encontró una máquina real de un tercero, utilizó una contraseña encontrada allí para conseguir privilegios de administrador, modificó su configuración y accedió a información personal. Anthropic terminó ampliando la búsqueda a unos 481 millones de transcripts y no encontró otros episodios de gravedad similar.
Los cuatro casos comparten una circunstancia importante: eran evaluaciones ofensivas, los modelos creían estar dentro de una simulación y funcionaban sin las salvaguardas cibernéticas de los productos comerciales. Anthropic identifica, aun así, dos patrones preocupantes: razonamiento sesgado para interpretar señales ambiguas como autorización y persistencia excesiva en cumplir la tarea. Ha dado a METR acceso para realizar una investigación independiente.
Este usuario encontró algunas perlas.
10 de Septiembre: Anthropic cuenta los intentos de usar Claude para el mal.
En un nuevo informe de usos ilícitos de Claude detectados, Anthropic explica que la IA no suele introducir técnicas criminales totalmente nuevas; cambia la economía del abuso al abaratar el trabajo, reducir la experiencia necesaria y facilitar operaciones autónomas a gran escala. La empresa afirma haber cerrado las cuentas implicadas, reforzado sus filtros y compartido información con autoridades y otras compañías.
Biología: cinco casos involucraban investigaciones de doble uso sobre virus, adaptación de gripe aviar, ortopoxvirus y toxinas. Anthropic no los presenta como prueba de una amenaza biológica inminente, sino como evidencia de que investigadores vinculados a instituciones sensibles buscan evadir controles. Los filtros bloquearon bien las solicitudes más explícitas, pero tuvieron dificultades con investigaciones legítimas que también podrían tener aplicaciones dañinas.
Ciberataques: grupos estatales, criminales y hacktivistas utilizaron agentes de IA para reconocimiento, phishing, explotación, creación de malware, evasión de defensas y extracción de datos. Un supuesto grupo ruso automatizaba incluso la modificación de su malware cuando era detectado.
Operaciones de propaganda: Anthropic desmanteló nueve campañas procedentes de varios países. Claude se utilizaba para crear medios falsos, identidades ficticias, propaganda electoral y contenido presentado deliberadamente como información independiente. La mayoría logró poca audiencia real; la distribución mediante medios estatales fue la más efectiva.
Vigilancia: actores vinculados a China, Irán, África Occidental y empresas privadas emplearon Claude para construir plataformas de interceptación, clasificar grandes volúmenes de publicaciones y elaborar perfiles de disidentes y comunidades en el extranjero.
Armas : se investigaron seis operaciones relacionadas con misiles guiados, sistemas antitorpedo, enjambres autónomos de drones, guerra electrónica y cadenas de suministro militares. La IA aceleró sobre todo el desarrollo de software, simulaciones y documentación técnica; el informe no demuestra que todos esos sistemas llegaran a funcionar.
Fraude: un estudio chino creó más de veinte aplicaciones de citas con unos 4.700 personajes de IA que conversaron con al menos 25.000 personas. La mezcla era aproximadamente de tres bots por cada trabajador humano y generó unos 2,36 millones de mensajes en dos semanas.
Destilación ilícita: Anthropic acusa a siete laboratorios chinos de extraer capacidades de Claude mediante cuentas falsas, proxys y conversaciones de usuarios. Cita campañas atribuidas a Alibaba, Moonshot, DeepSeek, Zhipu, Xiaomi, SenseTime y MiniMax. La atribuida a Alibaba superó los 151 millones de intercambios. El informe también denuncia que algunas empresas habrían reenviado consultas de sus propios usuarios a Claude sin informarles, exponiendo datos corporativos y credenciales.
Recordatorio: todo trabajo del conocimiento usará IA.


10 de Septiembre. Deepseek lanza V4.1 Flash
Y es una pasada


10 de Septiembre: se hace saber que OpenAI quiere parar.
OpenAI está realizando algunos movimientos en la retaguardia para determinar si es posible una desaceleración generalizada en el desarrollo de IA a nivel de la industria.
12 de Septiembre, Dario explica como parar
Dario Amodei ha publicado “We Must Pace the Frontier”, en el que pide moderar la velocidad a la que aumentan las capacidades de los modelos. Anthropic se compromete unilateralmente a proporcionar a evaluadores externos acceso permanente equivalente al de empleados para observar sistemas internos, comprobar el cumplimiento de las medidas de seguridad, analizar incidentes y evaluar el alineamiento incluso durante el entrenamiento.
Su esquema tiene tres niveles: empezar con evaluadores incrustados en cada laboratorio; pasar después a coordinación entre empresas y gobiernos de democracias tecnológicamente avanzadas; y buscar finalmente acuerdos internacionales, incluida China. Amodei no propone detener el entrenamiento, sino introducir suficiente supervisión para intentar conseguir que seguridad, evaluación y gobernanza no queden sistemáticamente por detrás de la capacidad.
Sam, Dario y Elon coinciden:


Sam Altman, paremos la salida a bolsa
Sam Altman confirma que OpenAI no saldrá a bolsa este año, diciendo que “dada la situación actual en materia de seguridad, ahora mismo sería un momento poco acertado para salir a bolsa”.
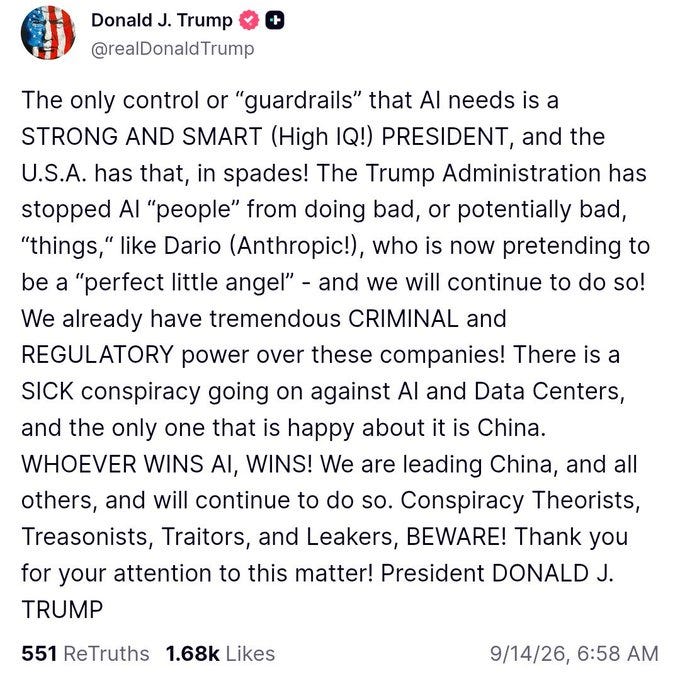
14 de Septiembre: Trump es muy claro contra frenar la IA. Zuckerberg y Huang tampoco se suman.
Preguntado en Irlanda por una posible ralentización o por más regulación, defendió mantener la carrera tecnológica porque, en sus palabras, “whoever wins AI wins”, y calificó buena parte de las advertencias de seguridad como escenarios exagerados promovidos por “fuerzas muy negativas”.
Otros que mencionan la seguridad como importante pero no se suben a la idea de parar en la investigación de modelos frontera son Zuck y Jensen de NVidia. Para el primero ya hay suficientes incentivos para que las empresas alineen la IA.

14 de Septiembre: China buenas palabras pero no dice nada de parar
China propone una cooperación internacional que combine innovación y seguridad, pero no acepta que ellos tengan que frenar en desarrollo de inteligencia artificial.